

 86浏览
CIKM 2026: One Size, Many Fits Aligning Diverse Group-Wise Click Preferences in Large-Scale Advertising Image Generation (在大规模广告图像生成中对齐多元人群点击偏好)
论文链接:https://arxiv.org/abs/2602.02033
代码&数据集(加班加点开源中):https://github.com/JD-GenX/OSMF
先上一张图。这张图是我们论文的"一图流",讲的是电商广告图优化这些年的"职场血泪史":
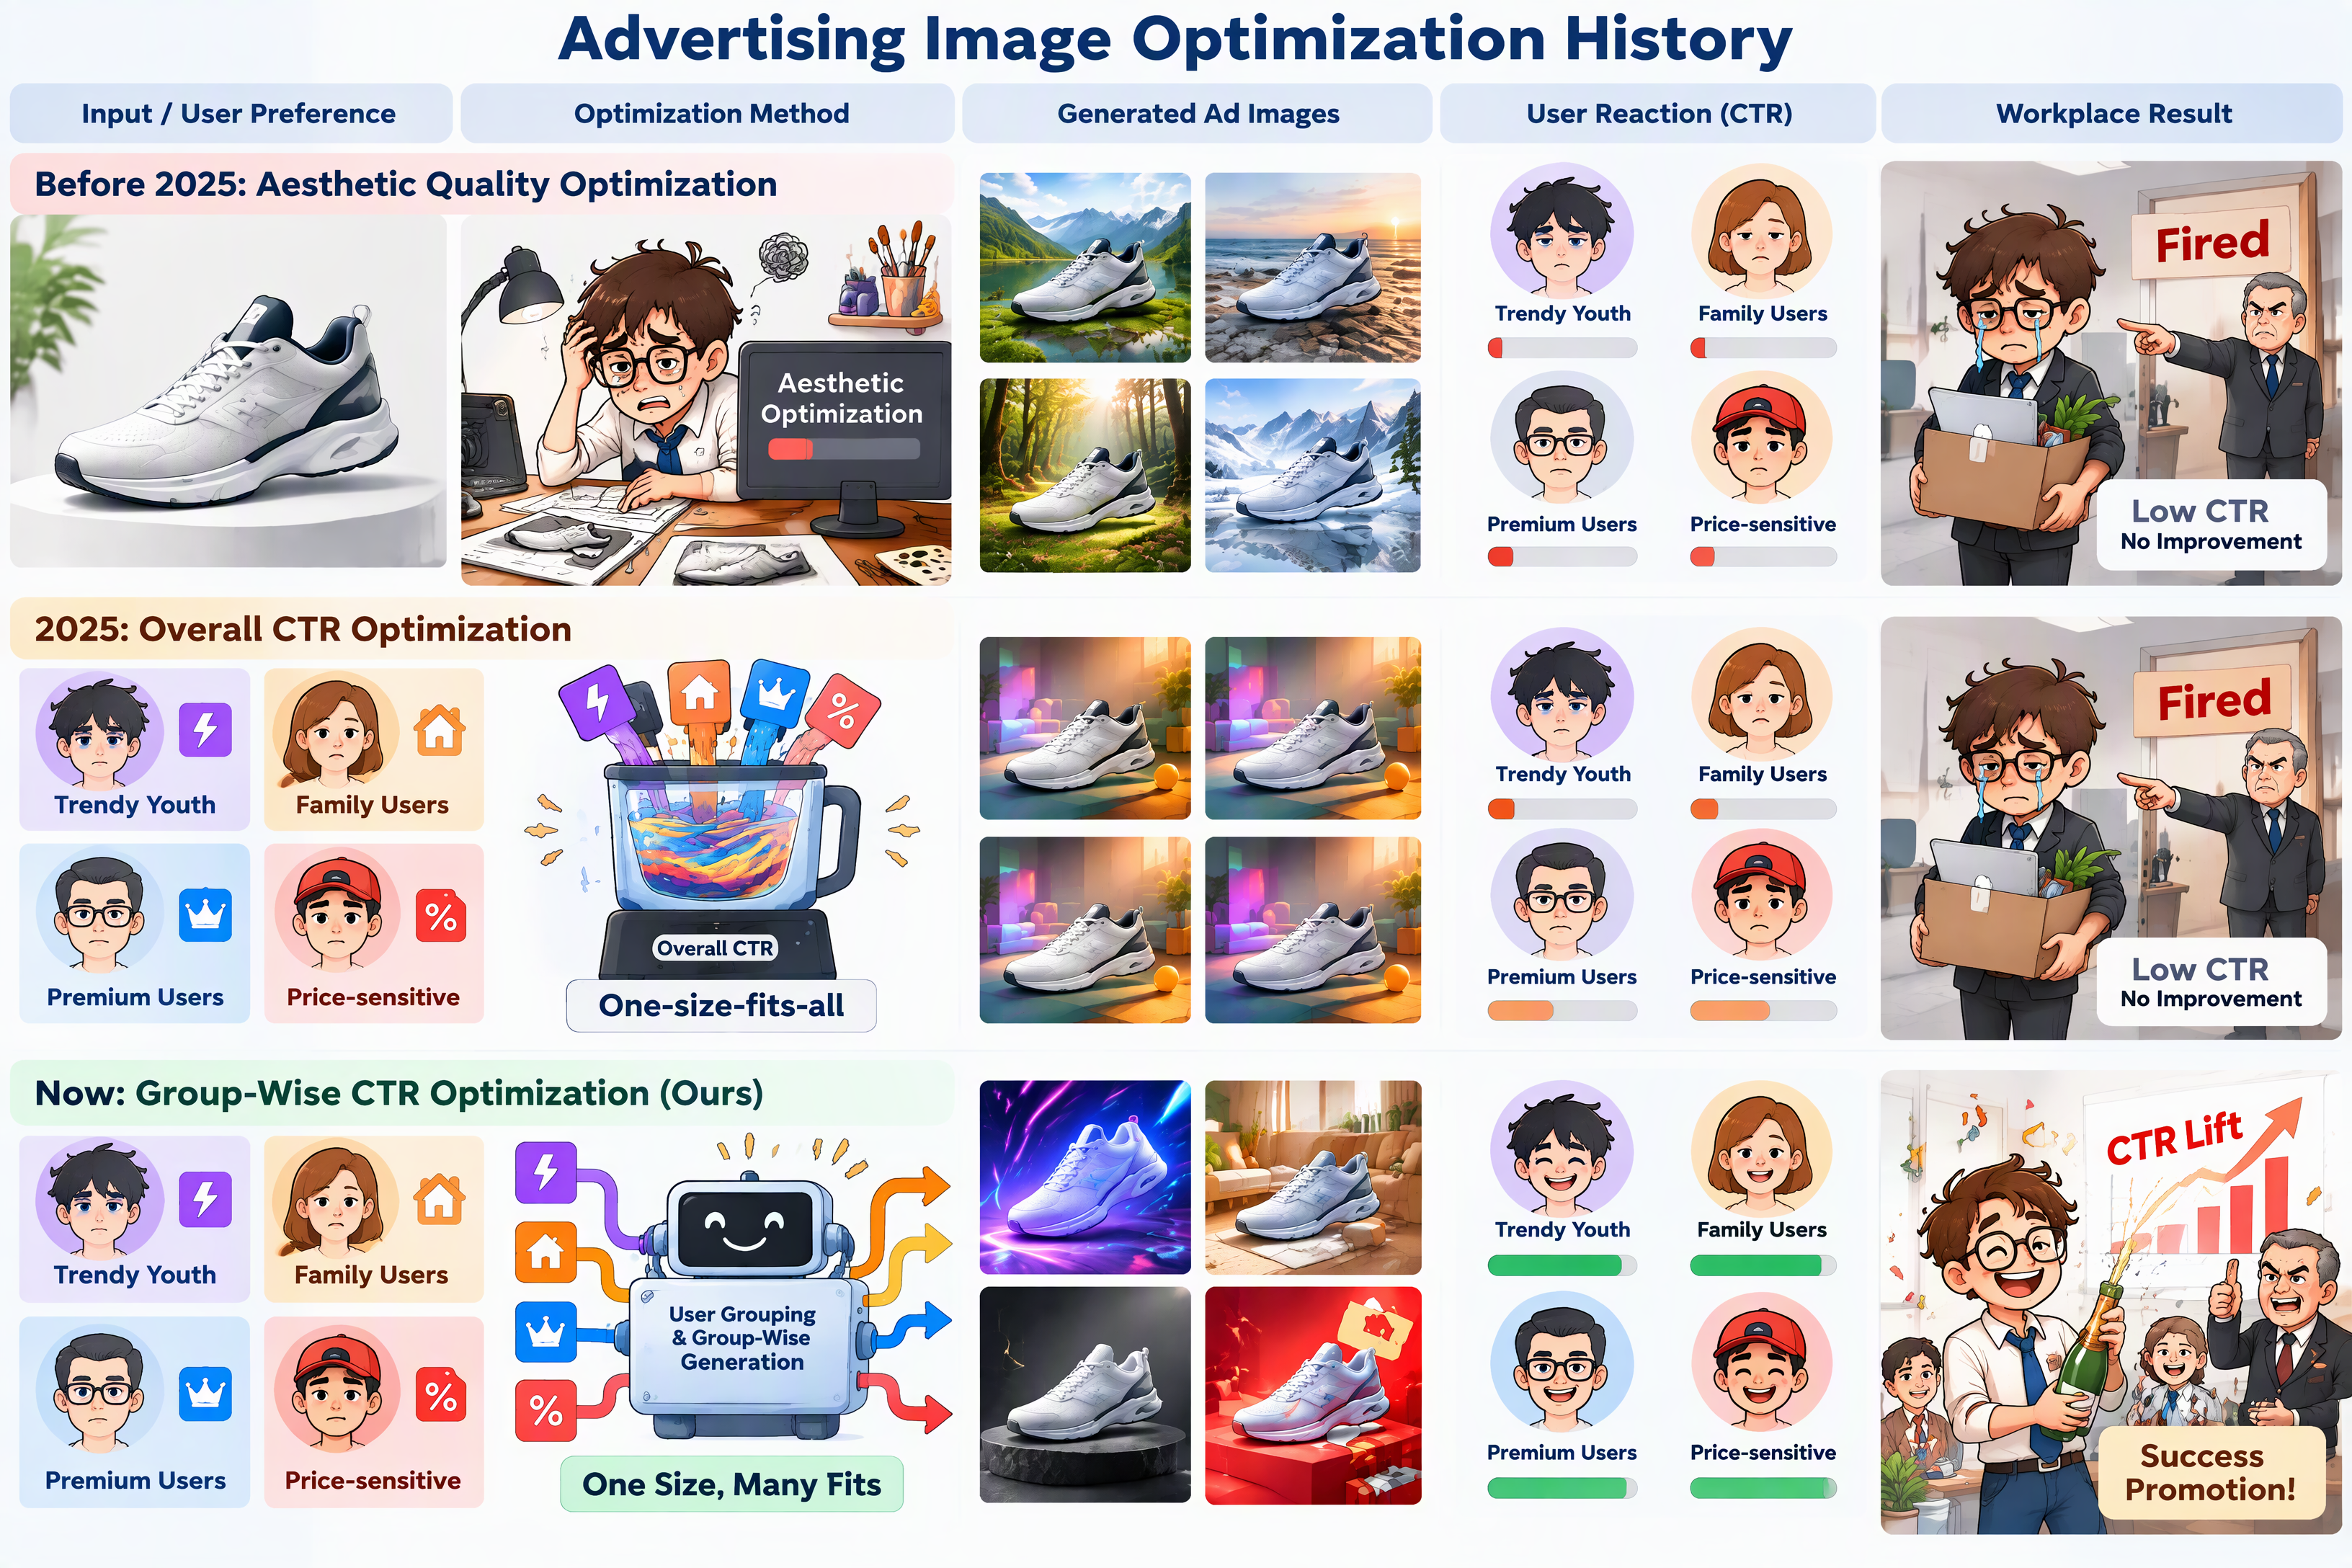
图1:面向图片美学的优化 & 面向全平台用户的CTR的优化 已经渐入荒境,人群化 & 个性化的图片生成才是未来。
一、三个时代,两度"哭唧唧"
我们把广告图优化的发展史,浓缩成了三行剧情。请对照上面那张图一起看:
第一幕 · 2025 年之前:我们卷美学。我们熬夜修图、调色,产出一批"美到可以当壁纸"的广告图。结果用户无动于衷,CTR 纹丝不动。老板直摇头,教训一句话:图片变美 ≠ 点击率变高。
第二幕 · 2025 年:我们卷整体 CTR。这回我们学聪明了,直接拿点击率当目标做优化生成链路。但楼上用户老冯喜欢简约的背景,楼下用户小屾喜欢复杂的背景,于是我"一刀切"地生成了既简单又复杂的背景,结果他俩谁也不买账。老板还是直摇头,教训还是一句话:样样通就是样样松。
第三幕 · 2025-2026:我们卷"人群化创意生成"。我们研究每个人群喜爱的图片类型,为同一件商品分别生成风格迥异、但精准对味的广告图。于是用户点击齐刷刷,CTR 上涨顶呱呱,算法开发笑成花,升职加薪老板夸!
第三幕又称One Size, Many Fits (OSMF),就是我们这篇 CIKM 2026 论文的全部灵魂。下面讲讲,这个"能出成绩"的方法到底是怎么做的。
二、为什么"一刀切"会"哭唧唧"?
现在业界基于CTR进行广告图片生成优化的工作本质上都默认了一个假设:"整体用户偏好对所有人都适用。" 但在一个包含上亿用户的电商平台上,这个假设脆得像薯片。于是我们大胆喊出:我们要基于每个用户群体的CTR生成最适合该群体的广告图片!(原话其实是:再跟原来那么做,我们就凉了!)
这么浅显的道理,为什么业界不直接这么做呢?想法对,但工业界落地有两个"拦路虎":
第一,定义“每个用户群体”太难了:为每个用户群体生成广告图片,那么这个用户群体就应该有“相似的对广告图片的偏好”。但是对于王大爷卖的商品,依靠性别就能准确划分人群,卢老师卖的商品,只能靠年龄划分人群,那么面对还包含了赵钱孙李周吴郑王等商家卖的商品的平台,一套死规则根本管不过来所有商品的人群划分规则
第二,不同用户群体的偏好千奇百怪,还经常互相矛盾:业界研究大模型的那群人,不是没关注过“不同人群的差异”这个问题,但是他们大部分都是在“一个答案让同时让所有人都满意”。在广告图片领域,这可做不到。例如前面说的老冯和小屾的例子,咱们可没办法生成又简约又复杂,又黑又白,又红又绿的图片。
再加上一个老大难:学术界根本没有大规模、真实、带人群标注的数据集可用。于是我们干脆把这几个坑一起填了。
三、OSMF 怎么做到"人群化创意生成"?
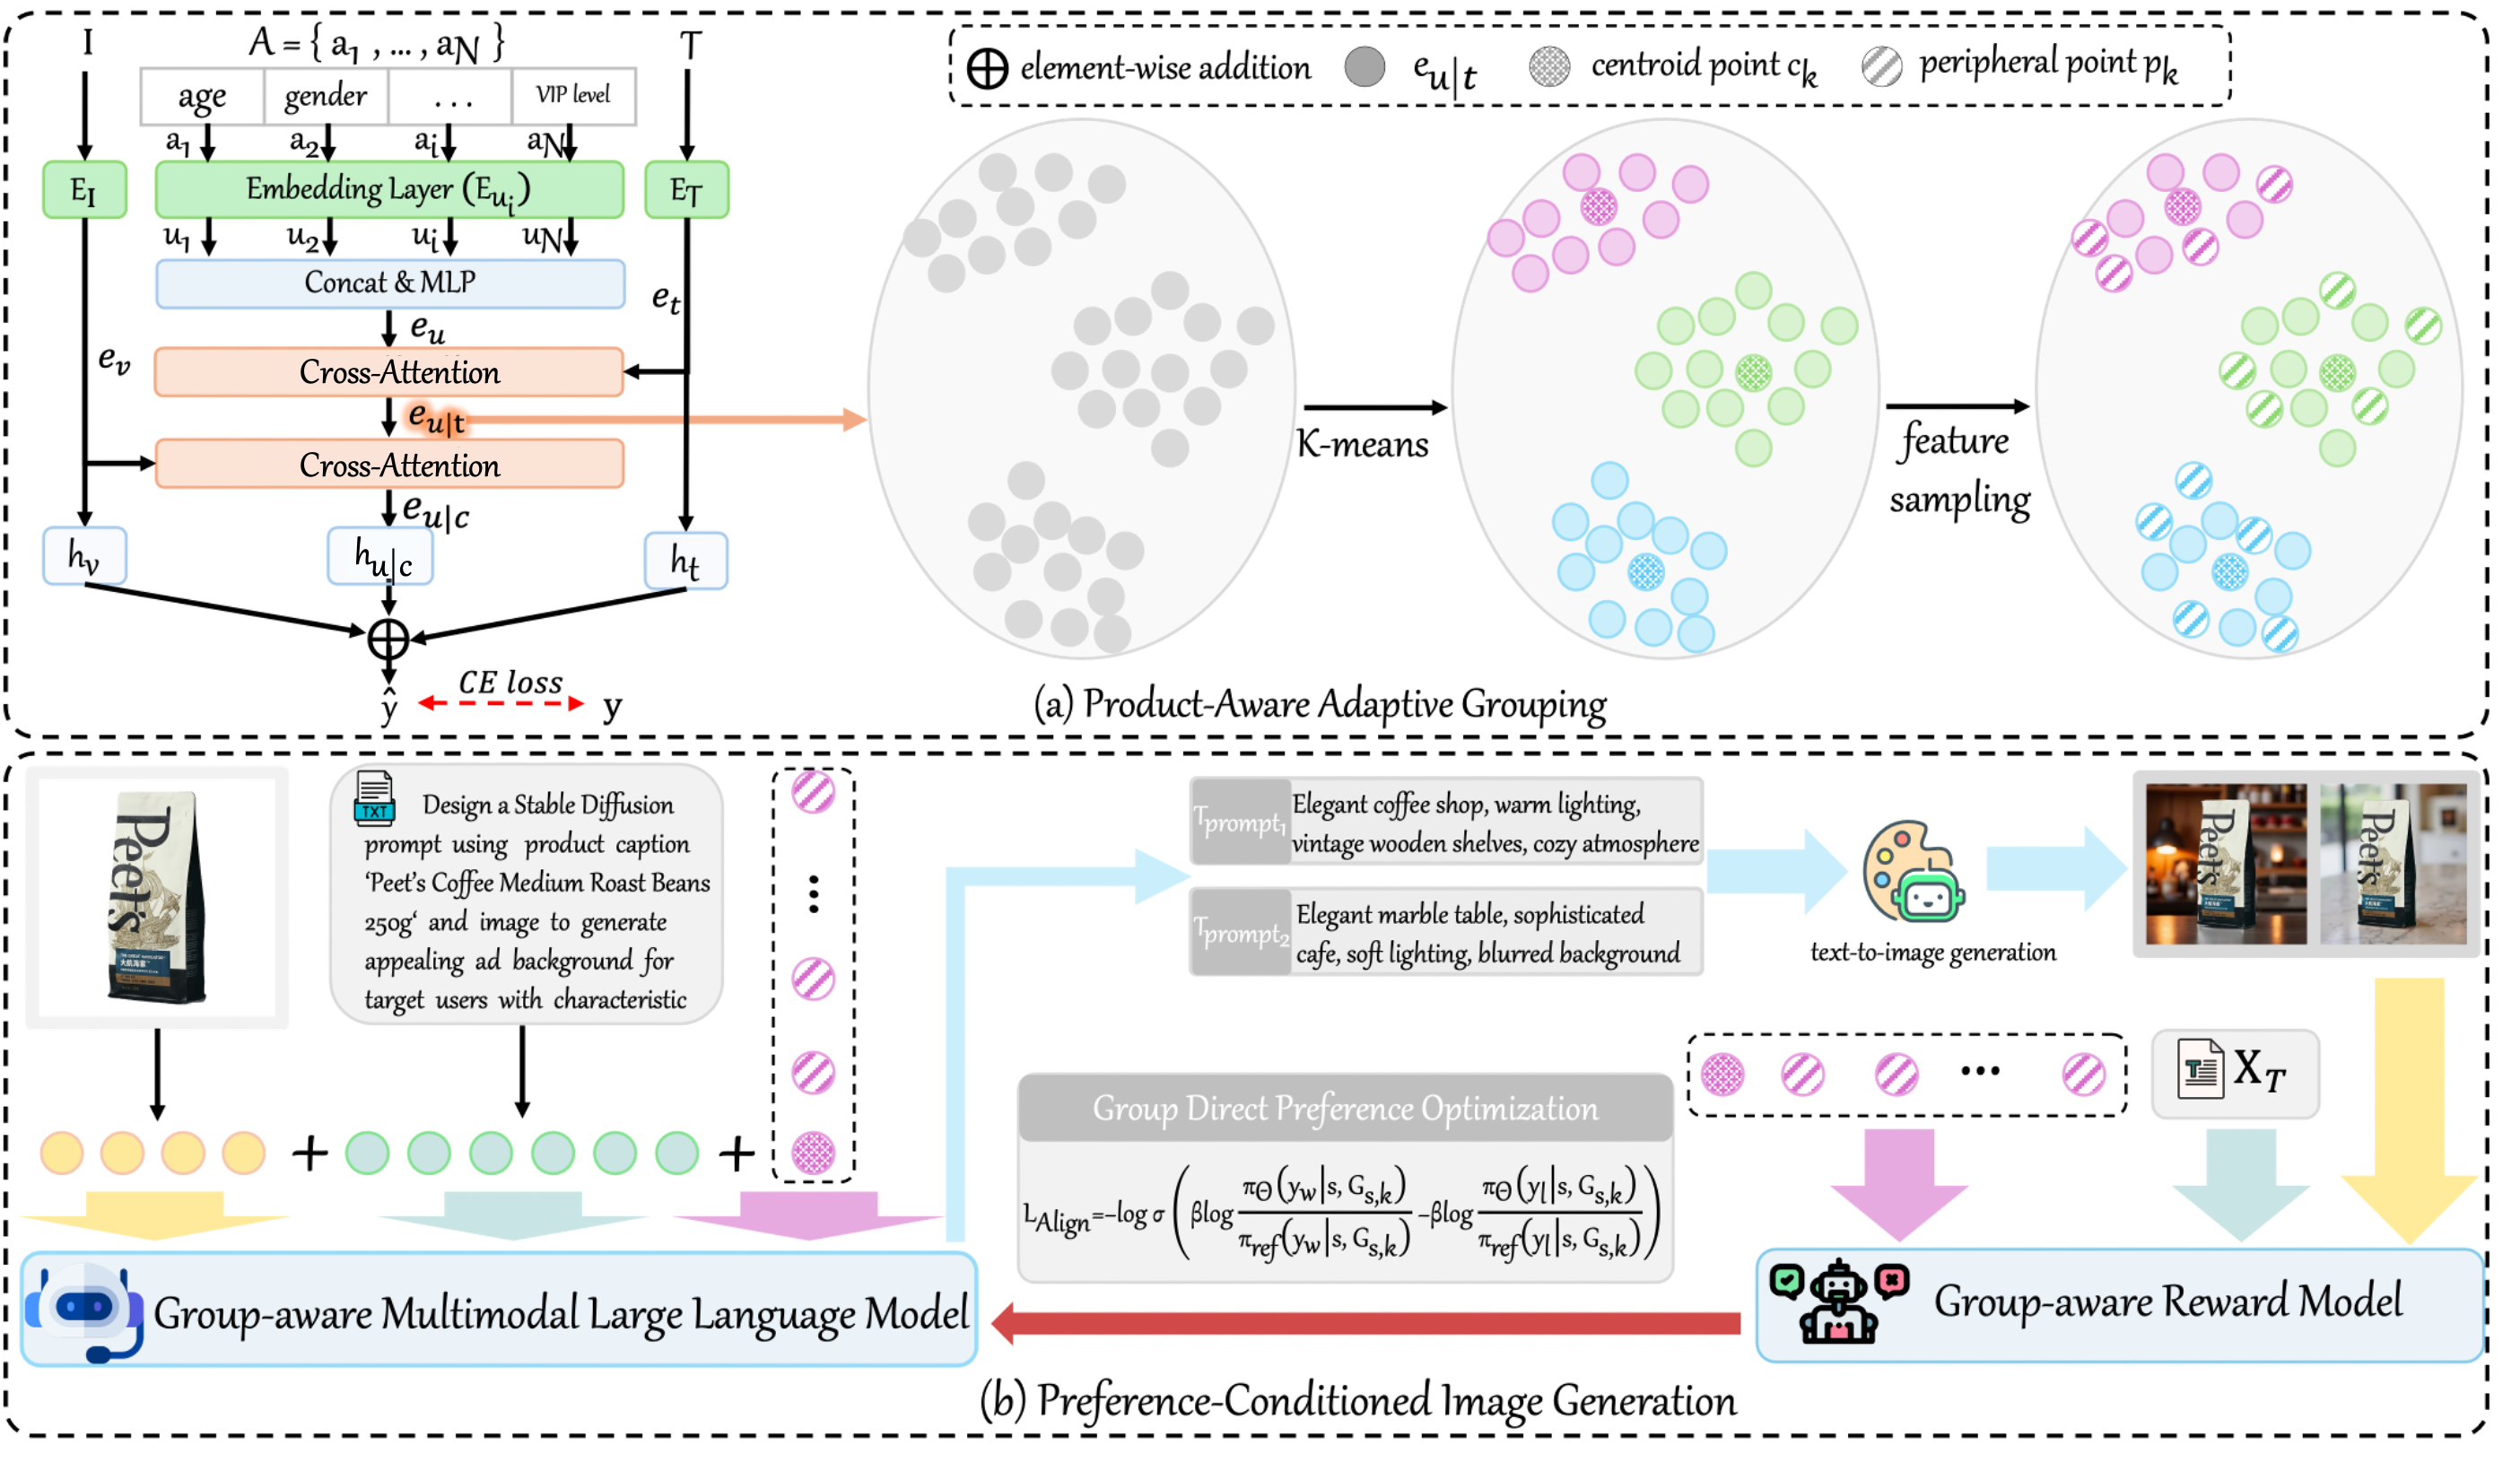
图2:OSMF框架图
整套方法两步走,外加一个首创数据集。楼上是我们放的一个论文里的图,对技术细节感兴趣的同学可以直接看论文。对技术细节不感兴趣的同学,请直接看下面我说的人话。
第一步:PAAG —— 会"看菜下饭"的智能分组。
PAAG 全称"商品感知的自适应人群分组"。它不用死规则,而是把用户属性(性别、年龄、地域……)和当前商品揉在一起,学出"针对这件商品,这个用户到底爱看啥"的偏好表征。再学术点说,我们训练了个模型,输入用户 & 商品 & 图片,预测是否点击;训练完后,只输入用户 & 商品,就能得到一个既懂商品、又懂视觉的用户偏好向量。
然后我们按商品做自适应数量的聚类,得到每个用户群体的偏好表征。考虑到用户个性化的复杂性,我们不只把聚类中心当成群体表征,还在距离中心远近不同的位置多采几个"代表点"作为补充——这样既抓住人群的"主流口味",又不丢掉边缘的"小众偏好"。
第二步:PCIG —— 一个模型,服务所有人群。
显然我们不可能为每个人群单独训一个模型:在上亿用户的平台上,这叫"钱包粉碎机",不现实。于是我们搞了个统一感知人群的多模态大模型 G-MLLM:把人群偏好表征拼到输入最前面,模型就知道"我现在是在给哪群人做图"。再用一堆巧妙的预训练任务(人群分析、行为预测、商品理解、Prompt 生成等等)把它喂聪明。最后,我们得到了一个“能够为每个人群生成图片提示词”的大模型(当然这个时候这个提示词质量挺一般的。。)。
接下来,我们要让这个输出的提示词“不再一般”。首先为了判断“输出的提示词到底一般不一般”,我们得知道"啥样的人群喜欢啥样的图"。为此我们把 G-MLLM 升级成人群感知奖励模型 GRM——给它一对图和一个人群,它来判断谁的 CTR 更高。有了这个"懂行的裁判",我们再基于裁判的反馈,用自研的 Group-DPO 对模型的输出做强化学习偏好对齐,直接教它"为这群人生成更高 CTR 的图"。跨人群的偏好冲突,就这么被化解了。
下面是Group-DPO损失函数的专业形式,不想看的可以跳过了:
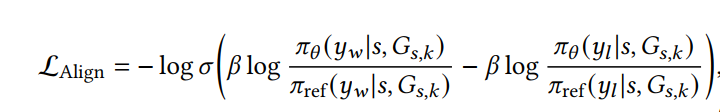
四、顺手造了个数据集:GAIP
做这行的都知道,人群级偏好研究最缺的就是数据——现有公开集要么太小,要么没有真实的点击交互。我们直接从真实工业广告日志里,攒出了 GAIP,并且全部开源。
这个数据集有多猛?4000 万用户、208 万件商品、956 万张广告图,20 类用户属性,三周真实点击行为。经过 PAAG 分群和低曝光过滤后,最终得到 61 万个真实用户人群的偏好样本。对比一下:多数公开的人群偏好数据集连 10 个人群都凑不齐,而我们有 60 多万个。(所有数据都做了匿名化和人群级聚合,隐私放心。)
五、实验结果
说再多不如上数字。
面向京东首页推荐信息流,相同SKU,相同人群下,OSMF生产的图片CTR相比“第一幕里的美学优化方法”涨了5.479%,相比“第二幕里的优化整体CTR方法”涨了1.987%。
六、一句话总结
"一刀切"的时代该翻篇了。One Size, Many Fits:同一件商品,为不同人群生成不同创意,让每个人都看到"对味"的那一张。我们把方法、代码和 60 万人群的 GAIP 数据集全部开源,就等你来一起把广告图继续卷到升职加薪。