

 41浏览
一张可用的电商海报,不仅要好看,还要让商品准确、文字清晰、风格统一。InnoAds-Composer 将这三类需求纳入同一个扩散生成过程,并通过精细化条件调度减少冗余计算,在生成质量与推理效率之间取得更好的平衡。
论文名称:InnoAds-Composer: Efficient Condition Composition for E-Commerce Poster Generation
发表会议:CVPR 2026
论文链接:https://arxiv.org/abs/2603.05898
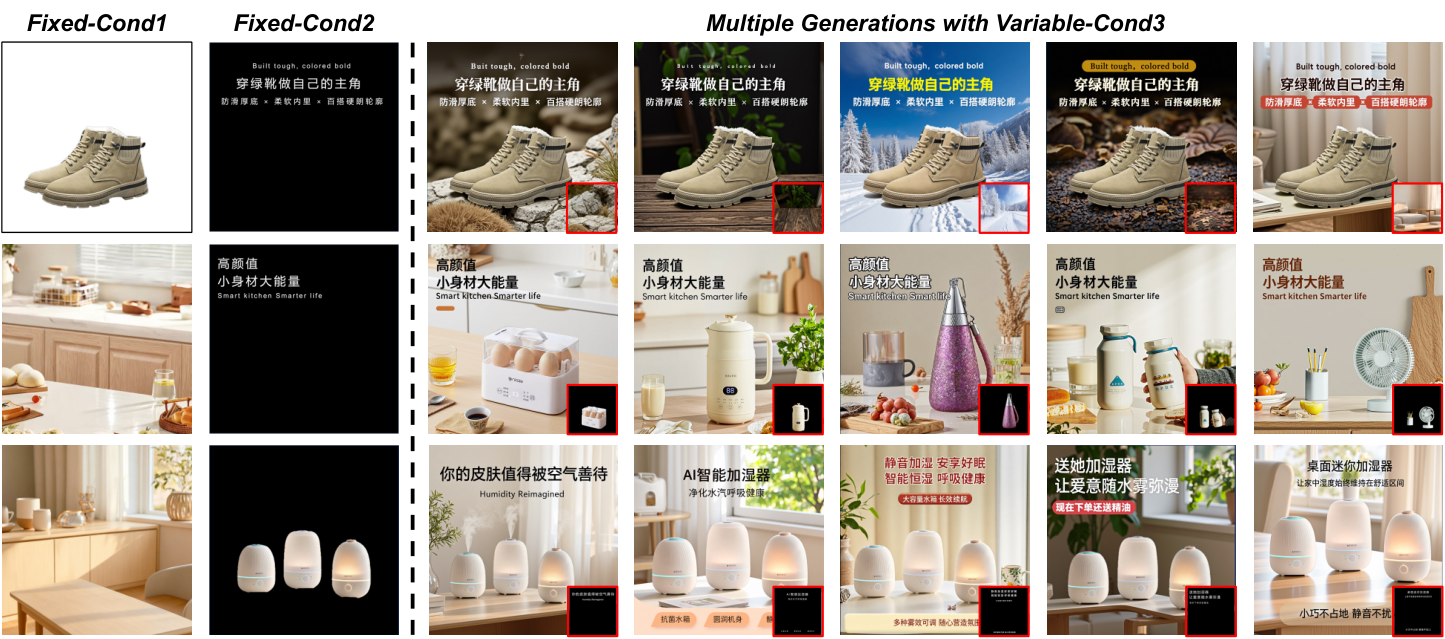
图 1:三类条件的独立控制效果。每一行改变其中一种条件,同时保持另外两种条件不变;生成结果展示了模型对背景风格、商品外观与文字内容的协调控制。
一、引言
随着扩散模型的发展,自动生成具有丰富细节与较高审美质量的图像已经成为现实。但从通用图像生成走向电商海报,模型面对的目标发生了变化:它不再只是自由创作,而是需要同时满足多项明确约束。
首先,商品必须准确呈现。商品是海报的信息核心,瓶身形状、包装配色、材质和局部结构都是外观的一部分。生成一件“看起来相似”的商品,并不等于准确展示了用户指定的商品。
其次,文字必须清晰且正确。标题、卖点与促销文案承担信息传递功能,不能被当作普通纹理处理。中文字符笔画密集、结构复杂,在小字号场景下尤其容易出现笔画缺失、字符变形或难以辨认的问题。
最后,背景风格必须符合预期。商家常常需要延续品牌视觉或活动主题,使不同海报在配色、光照、背景元素与空间氛围上保持一致。仅用“简约”“高级感”等提示词,往往难以完整表达参考图中的视觉关系。
更重要的是,这些目标不是彼此独立的。背景需要为商品和文字留出合适空间,商品应自然融入场景,文字也应与整体设计保持协调。因此,电商海报生成本质上是一个多条件、多目标的协同生成问题。
围绕这一需求,我们提出InnoAds-Composer:在统一生成框架中联合控制商品主体、文字字形和背景风格,同时研究如何减少多条件控制带来的计算开销。
二、背景
现有方法主要面临两类瓶颈:多阶段生成难以协调商品、文字与背景;直接拼接多类条件,又会增加 token 数量,带来平方级注意力开销。因此,我们希望在统一生成过程中实现三条件控制,并让条件只在更有效的层和时间步参与计算。
为支持训练,我们构建了InnoComposer-80K:80,000 个样本同时提供商品、字形和风格条件。通过商品分割、OCR 提取及背景编辑与生成获得配对数据,其中风格参考与目标海报保持语义一致、允许局部差异,鼓励模型学习风格而非复制背景。另设InnoComposer-Bench,以 300 个训练外样本评测文字、商品、风格与整体质量。
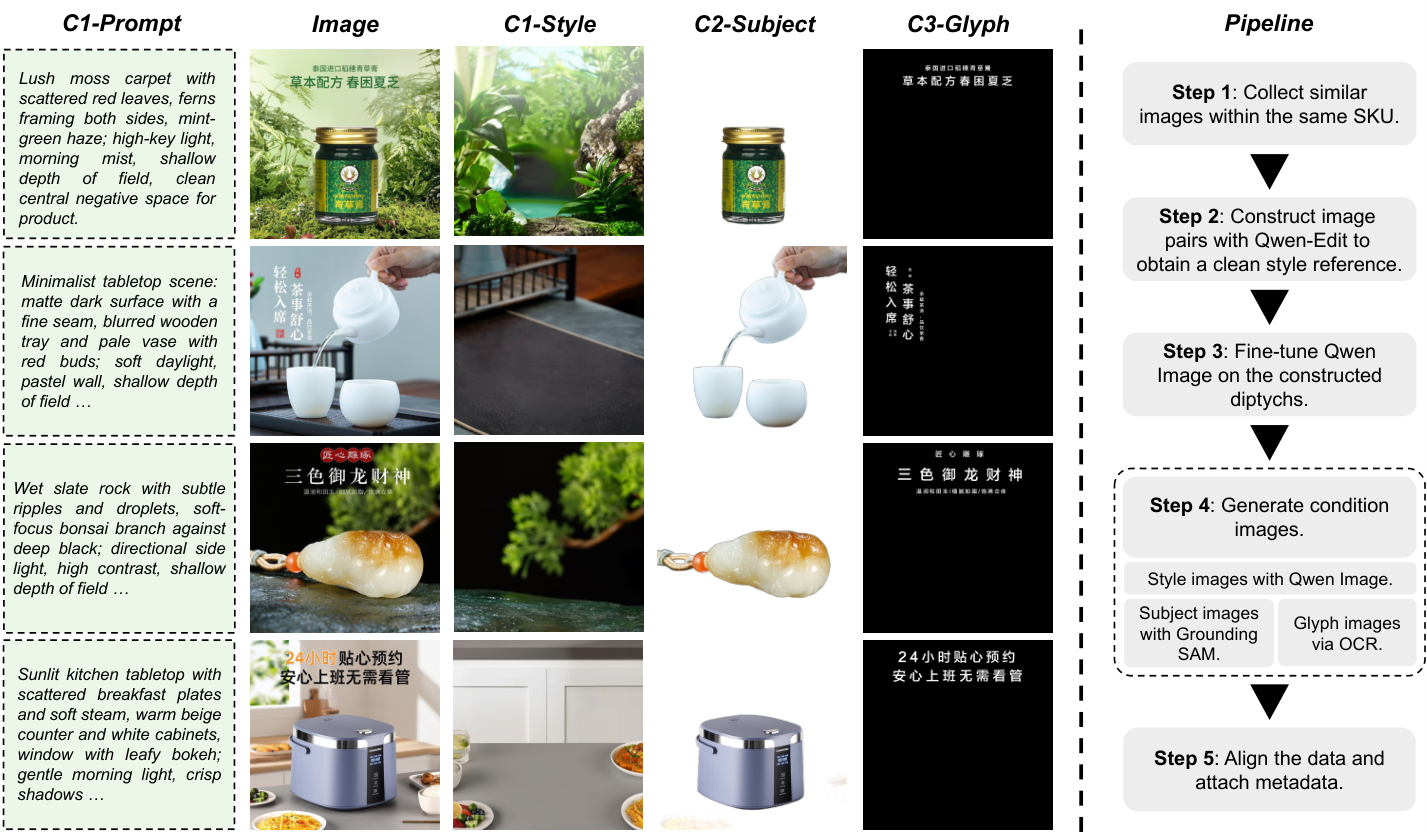
图 2:数据样本与构建流程,通过 SKU 配对、背景编辑与生成、商品分割和 OCR 提取,获得三条件联合监督。对应论文 Figure 2。
三、方法
InnoAds-Composer 基于 FLUX 的扩散 Transformer 构建。整体设计包括多条件 token 化、文字特征增强、重要性感知条件注入与解耦注意力,并通过两阶段训练适应条件剪枝。
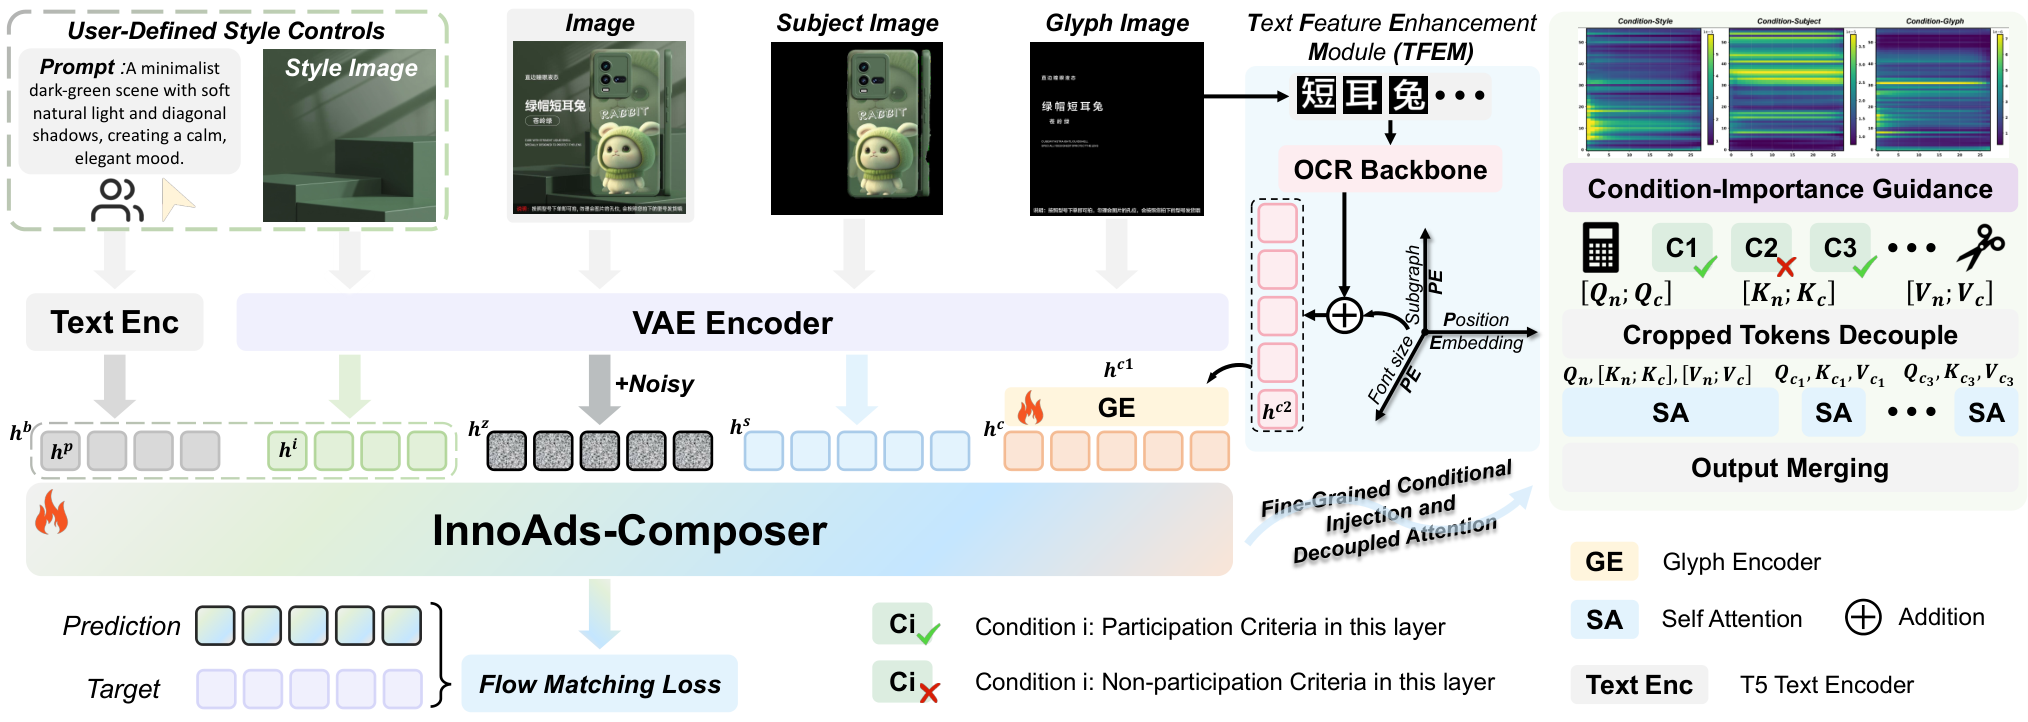
图 3:整体框架。商品、风格与字形条件进入统一 token 空间;文字特征增强模块补充局部字符信息;重要性感知注入和解耦注意力减少冗余条件计算。
3.1 多条件 Token 化
背景风格条件支持提示词或参考图片。参考图片经 VAE 编码与 patchify 后转换为视觉 token,提供配色、光照、材质及场景等信息;在图片风格模式中,与固定锚定提示词共同构成风格条件。商品主体条件先将主体以外区域填为黑色,再经 VAE 编码,减少背景信息干扰。这些 token 既携带商品结构与外观,也保留大致空间位置。文字字形条件则采用专门的增强模块,在提供整体排版信息的同时,补充细粒度字符结构。
统一表示的意义不是抹平三类条件的差异,而是让同一个主干能够读取并协调它们
3.2 字符增强模块TFEM
整张字形图能够提供明确的文字布局,但经过 VAE 压缩后,小字号文字和复杂笔画可能丢失细节。为了缓解这一问题,我们提出Text Feature Enhancement Module(TFEM),采用全局与局部两个互补分支。
- 全局分支:对整张字形图进行 VAE 编码,保留文本区域、行列组织与整体尺度关系。
- 局部分支:使用 OCR backbone 提取单字裁剪特征,并加入绝对位置、字号和裁剪内部局部位置三类编码。
随后,轻量级 Character Encoder 通过交叉注意力融合两个分支:以全局字形特征为查询,从局部字符特征中读取细节,再通过残差连接保留原有布局信息。
可以将这一设计理解为:
全局分支回答“文字如何排布”,局部分支回答“字符如何画准确”。
位置编码则将单字细节重新关联到画面中的正确位置和尺度,使细节增强服务于整体排版。通过这种全局—局部融合,TFEM 提升了字形清晰度、边界完整性与可读性。
3.3 重要性感知注入
我们先训练一个完整条件模型,再统计各类条件在不同网络层与扩散时间步上的注意力偏好,获得条件重要性分布。
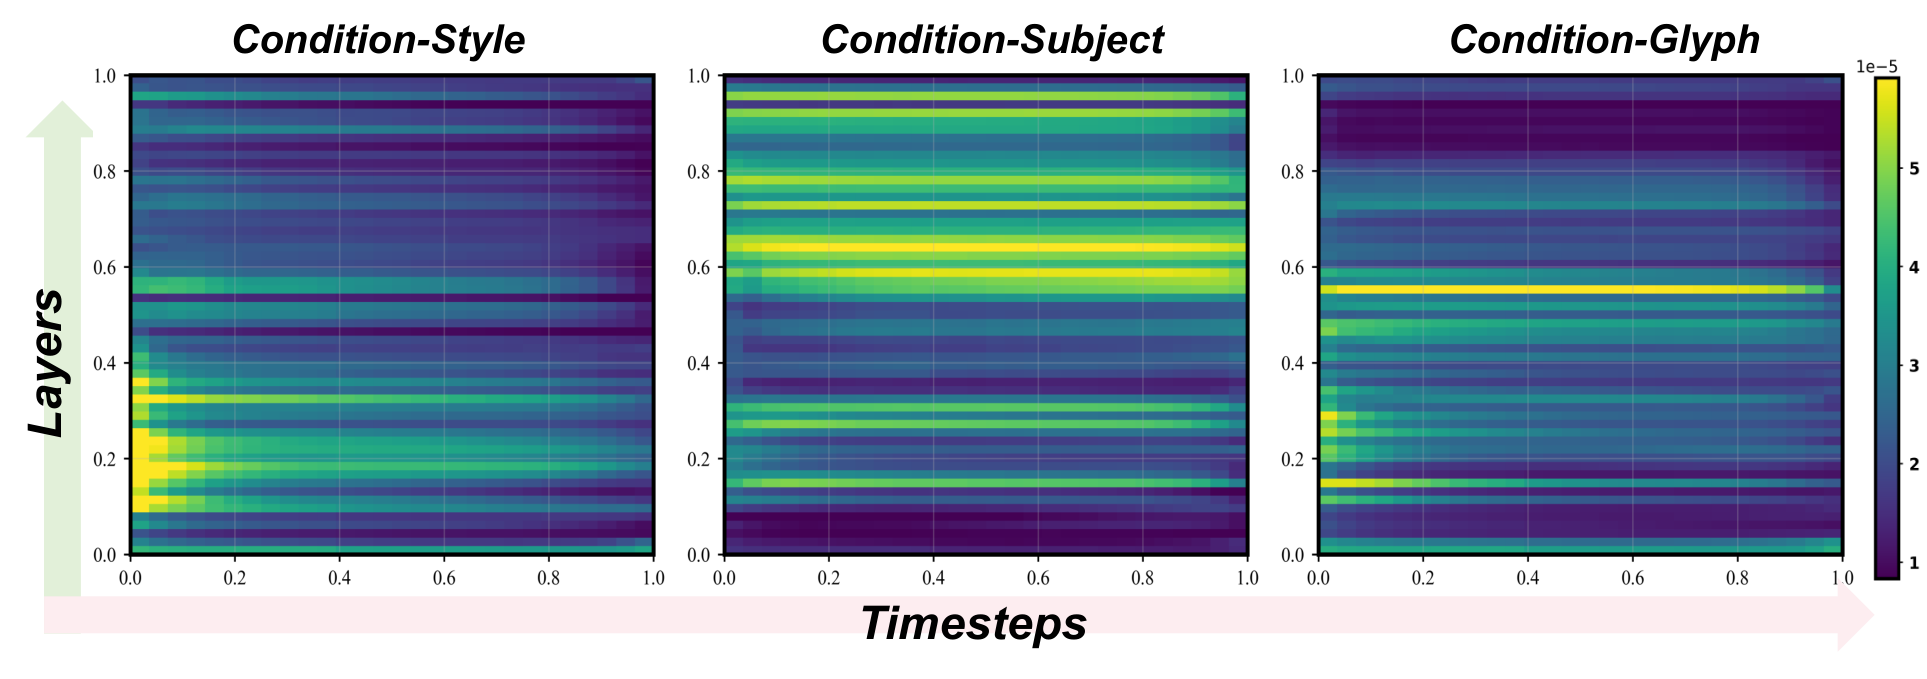
图 4:三类条件的重要性热图。背景风格偏向较早的层和生成阶段,商品在中深层持续发挥作用,字形在中间层和较晚生成阶段增强。
分析显示,三类条件具有非均匀且互补的影响模式:
- 背景风格在早层和较早生成阶段更为突出,随后逐渐衰减;
- 商品主体在中深层形成持续高响应,覆盖多数时间步;
- 文字字形在中间层和较晚时间步逐渐增强,对笔画与细节修整更重要。
基于这些分布,我们提出重要性感知条件注入:在更有效的层和时间步保留对应条件,在低响应位置省略其参与,缩短每层的有效序列。
默认配置下,字形、商品与风格条件的剪枝比例分别为80%、50% 和 60%,即保留比例分别为 20%、50% 和 40%。这些数值应结合按层和时间步的注入机制理解,并不代表删去相应比例的字符或商品像素。
这项设计的目标是:保留控制所需的关键参与,而不是让所有条件在所有位置重复计算。
3.4 解耦注意力
在完整注意力中,噪声图像与条件 token 可以双向交互。但商品参考、风格参考和字形参考是相对稳定的,没有必要在每个去噪步骤都读取变化中的噪声状态。
因此,我们采用非对称的交互方式:
- 噪声token感知自身与条件信息;
- 条件token只进行自身注意力,不再感知噪声token。
这种结构保留了条件指导生成的路径,同时去除了条件查询噪声的冗余交互。条件分支被设计为不依赖扩散时间步,其每个 block 的激活可以预先计算并缓存,在后续去噪中复用,进一步减少重复计算。
3.5 两阶段训练
在Stage I中,我们保留全部条件,充分学习三条件协同生成。MM-DiT blocks 使用 rank 为 256 的 LoRA 微调。在Stage II中,我们应用重要性感知剪枝,再以较低学习率继续微调,缓解条件参与方式变化造成的性能下降。该阶段还根据全局重要性分布调整时间步采样。
四、结果
4.1 定性结果
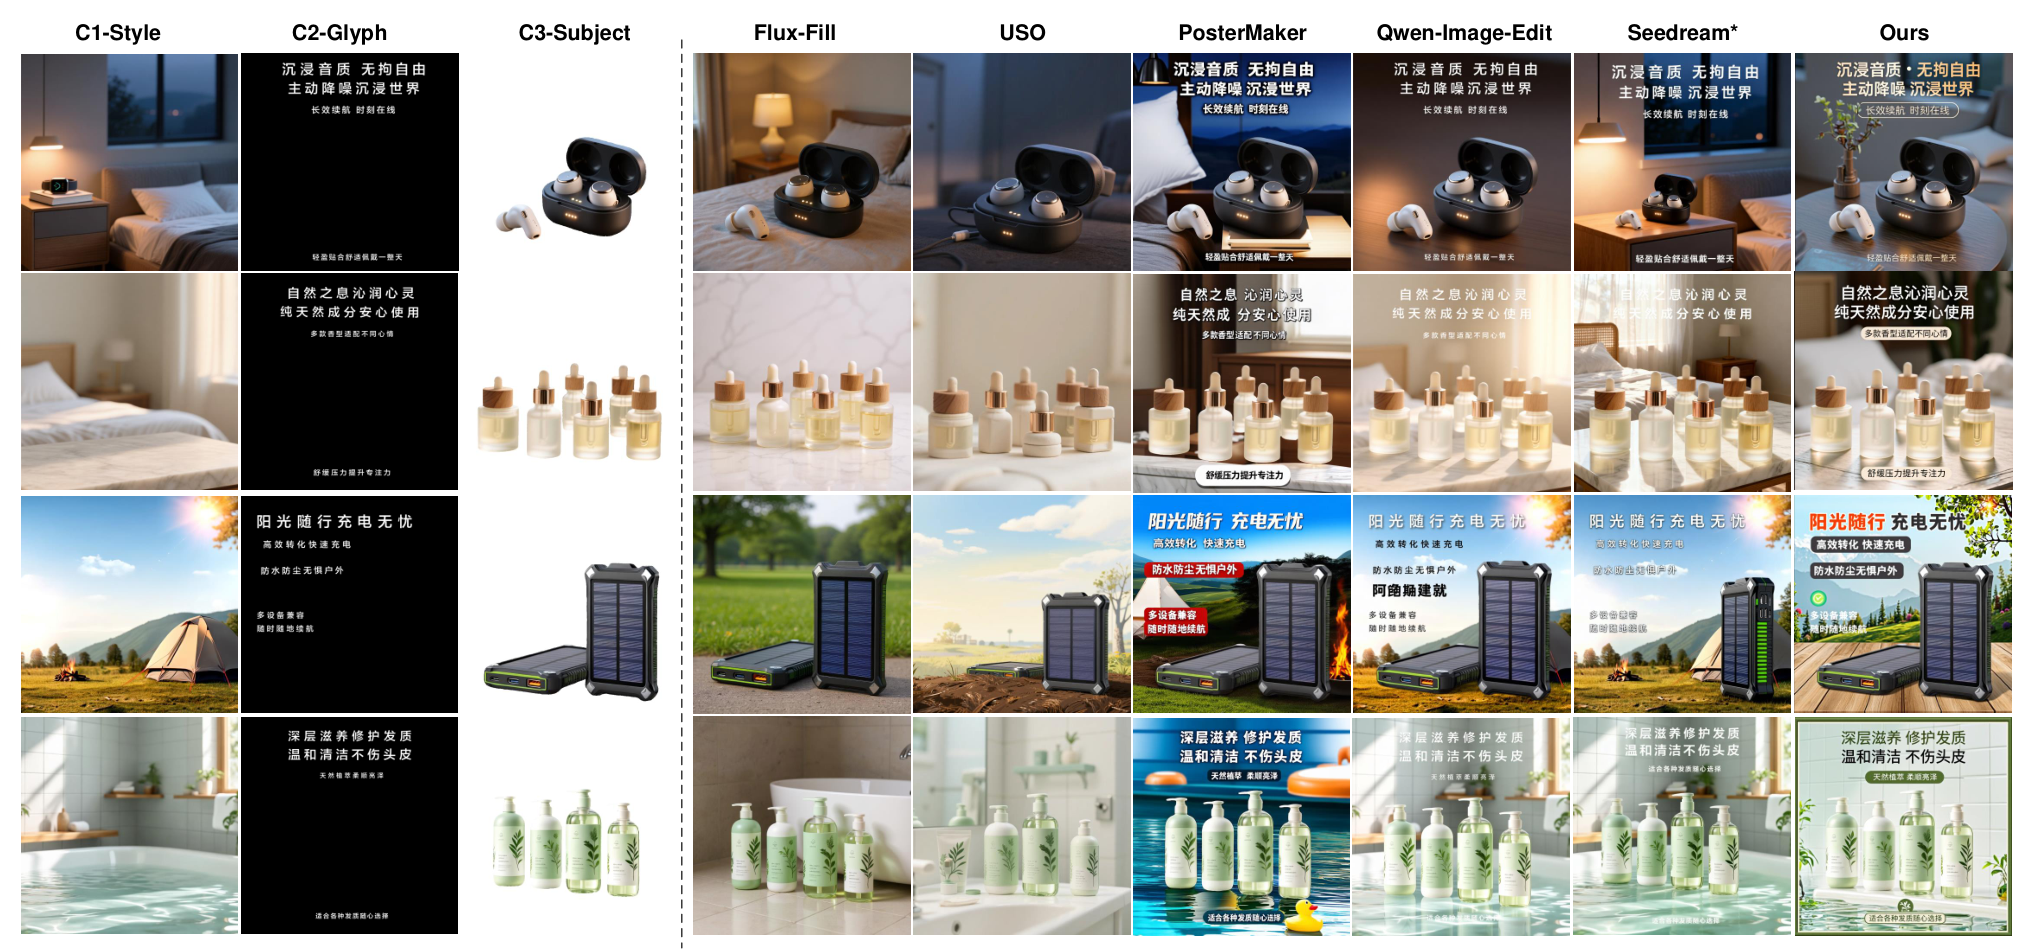
图 5:不同方法的生成结果比较。左侧给出风格、字形与商品条件,右侧展示各方法输出。InnoAds-Composer 在联合控制下兼顾商品外观、文字呈现与背景风格。
不同基线各有优势,但在三条件共同约束下仍面临挑战:部分方法主要处理商品或背景,不具备完整文字控制能力;部分方法可以生成商品和文字,却难以复现参考风格;支持多参考输入的通用模型也可能出现额外文字或较强的背景复制倾向。
InnoAds-Composer 将三类条件纳入共同生成过程,使商品、文字与背景能够相互协调。图 1 的独立条件变化实验进一步展示了可控性:改变其中一种输入时,另外两类要求仍能较好保持。
4.2 定量结果
我们使用四组指标评价结果:Sentence Accuracy 与 NED 衡量文字质量,DINO 与 IoU 衡量商品一致性,CSD 与 CLIP-I 衡量风格一致性,IR-Score 与 FID 衡量整体质量。其中,NED 按论文使用的评价方向为越高越好。
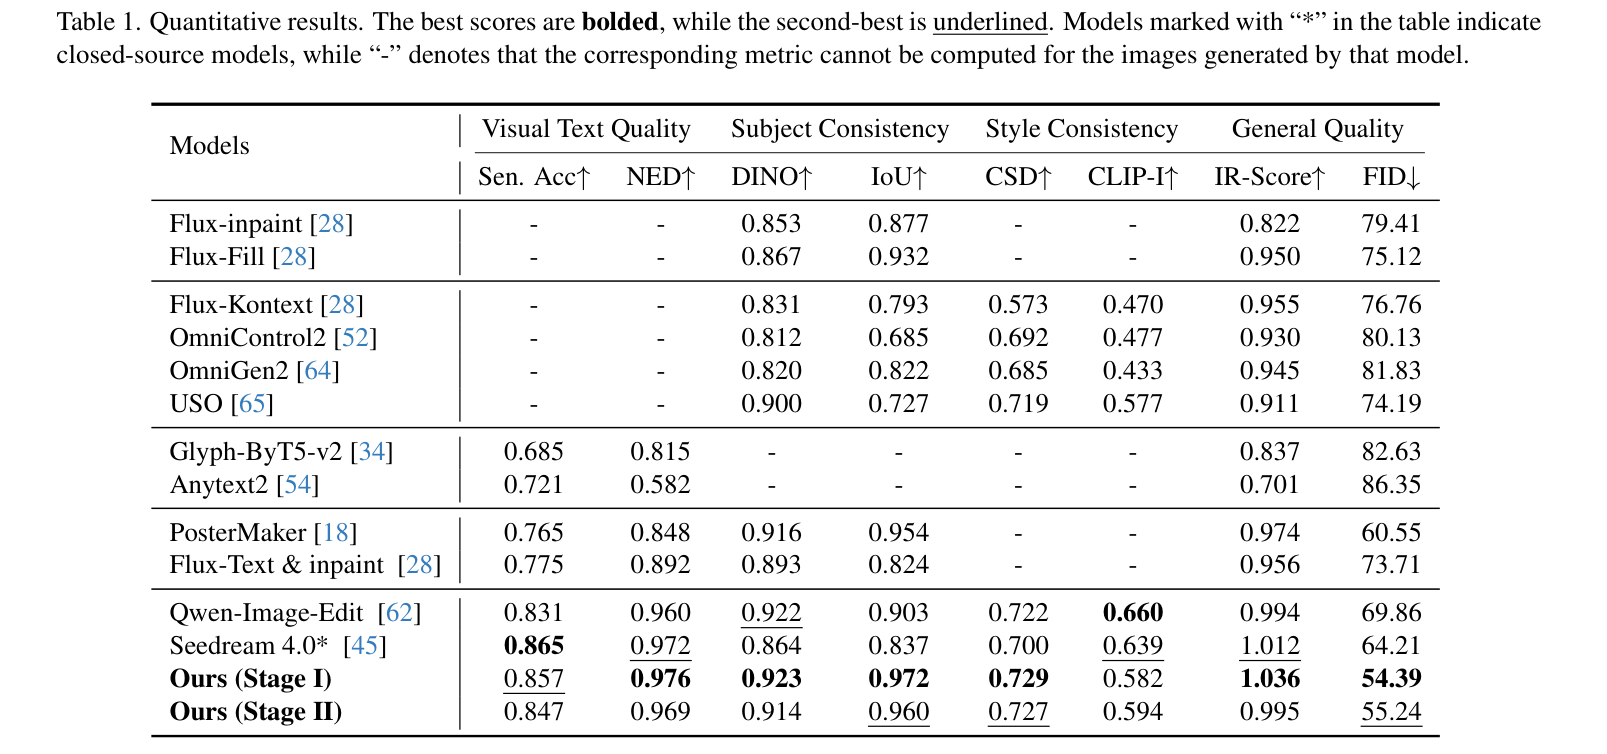
在论文列出的比较方法中,Stage I 在 NED、DINO、IoU、CSD、IR-Score 和 FID 上取得领先表现。这说明模型不仅提升了单一维度,也在多目标联合控制下保持了较强的综合质量。
4.3 消融结果
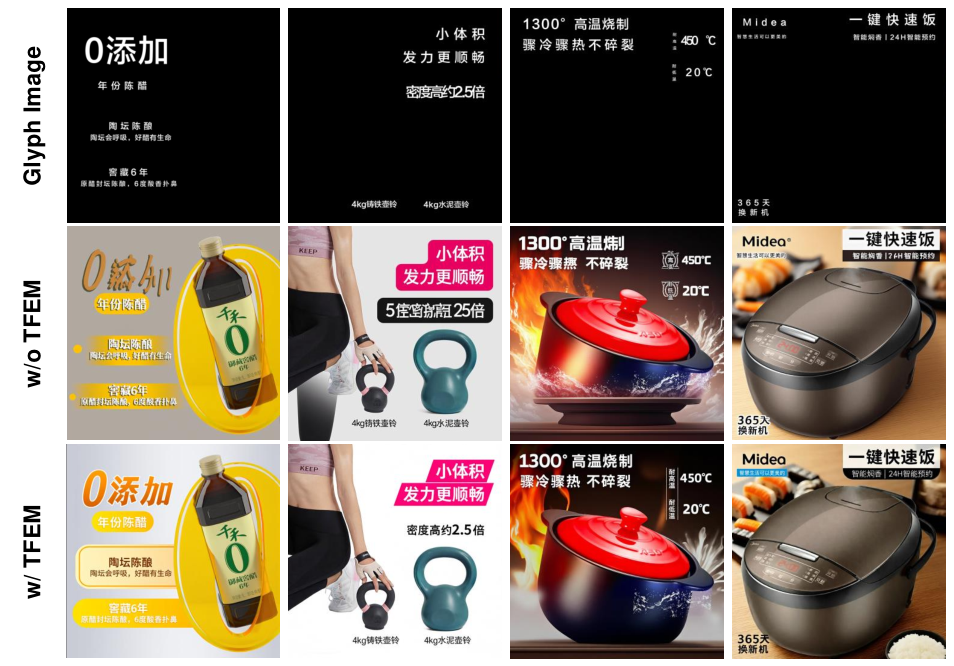
图 6:TFEM 消融。局部放大展示了文字特征增强对字符准确性与结构完整性的改善。对应论文 Figure 7。
文字模块消融显示,加入 TFEM 后,文字错误减少,论文报告 Sentence Accuracy 约有 5% 的改善。这验证了整图字形特征与单字特征融合的有效性。
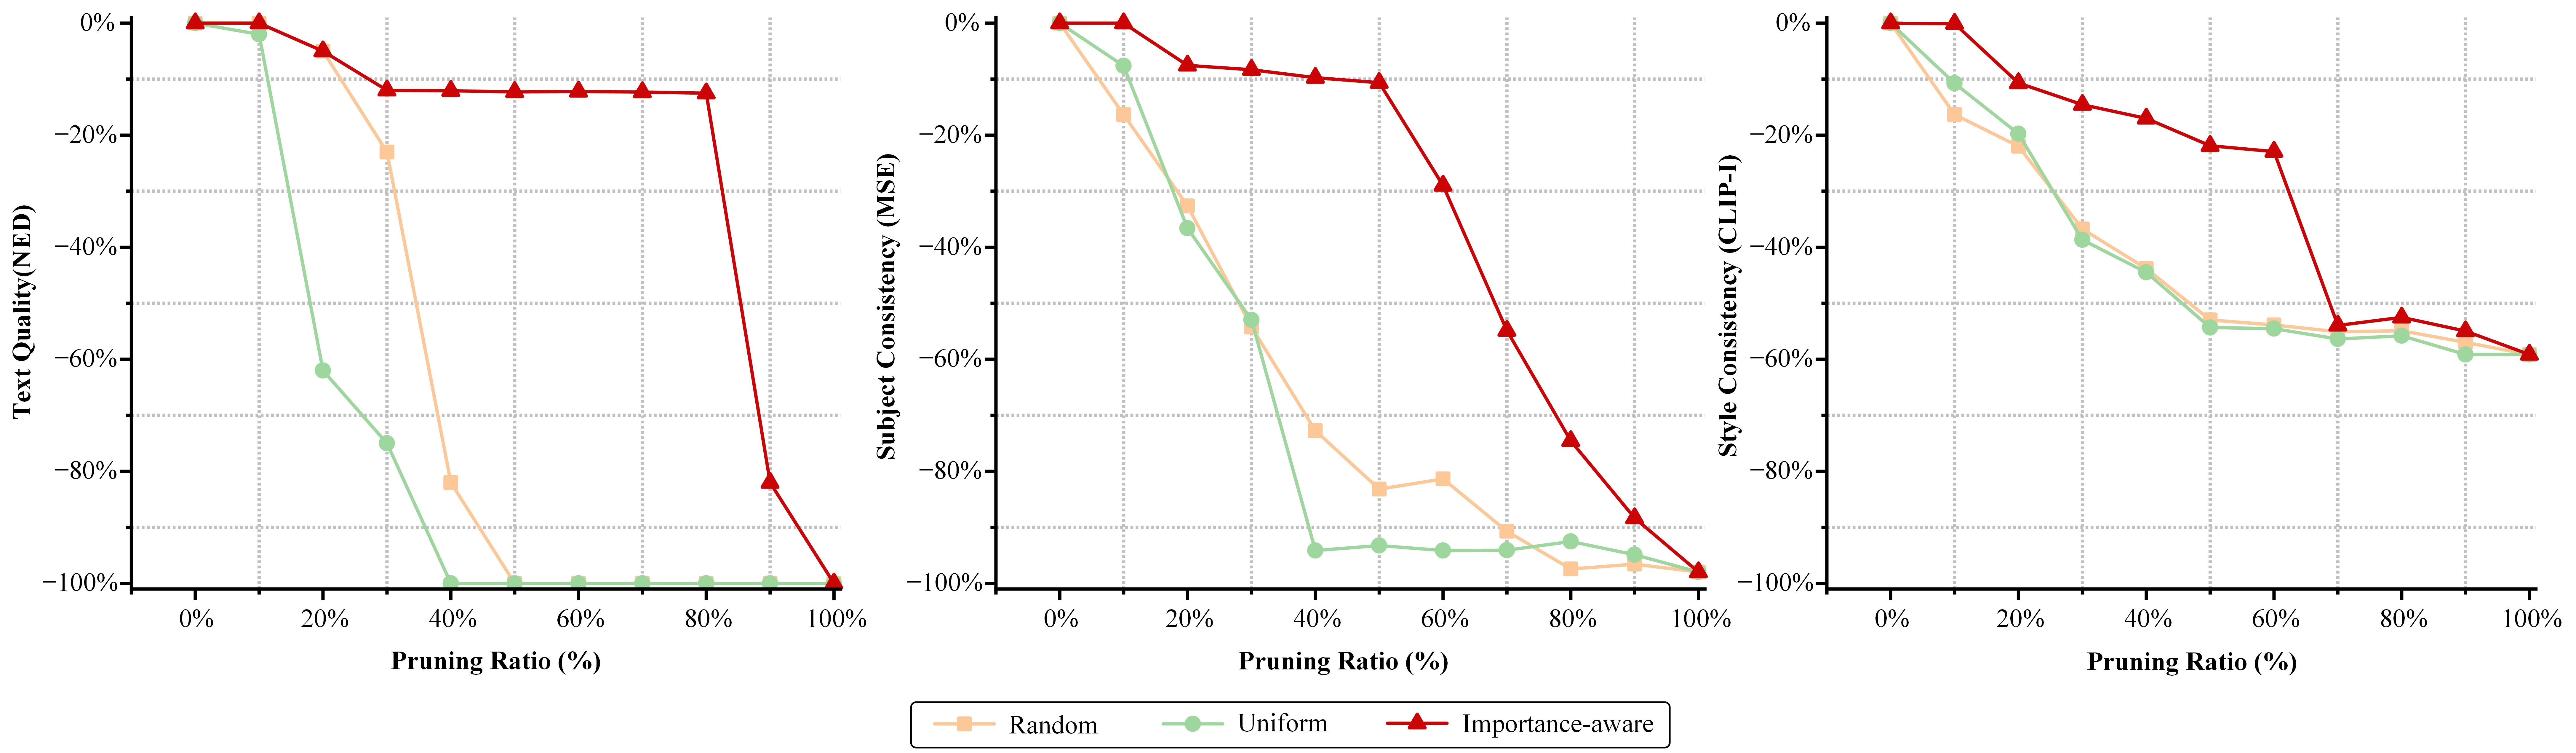
图 7:随机、均匀与重要性感知剪枝的比较。文字、商品和风格分别使用 NED、MSE 与 CLIP-I 评价;重要性感知策略在更大剪枝范围内保持较稳定的质量。对应论文 Figure 6。
剪枝实验表明,随机或均匀省略条件会更快损害生成质量,而重要性感知策略能够优先保留更有效的参与位置。
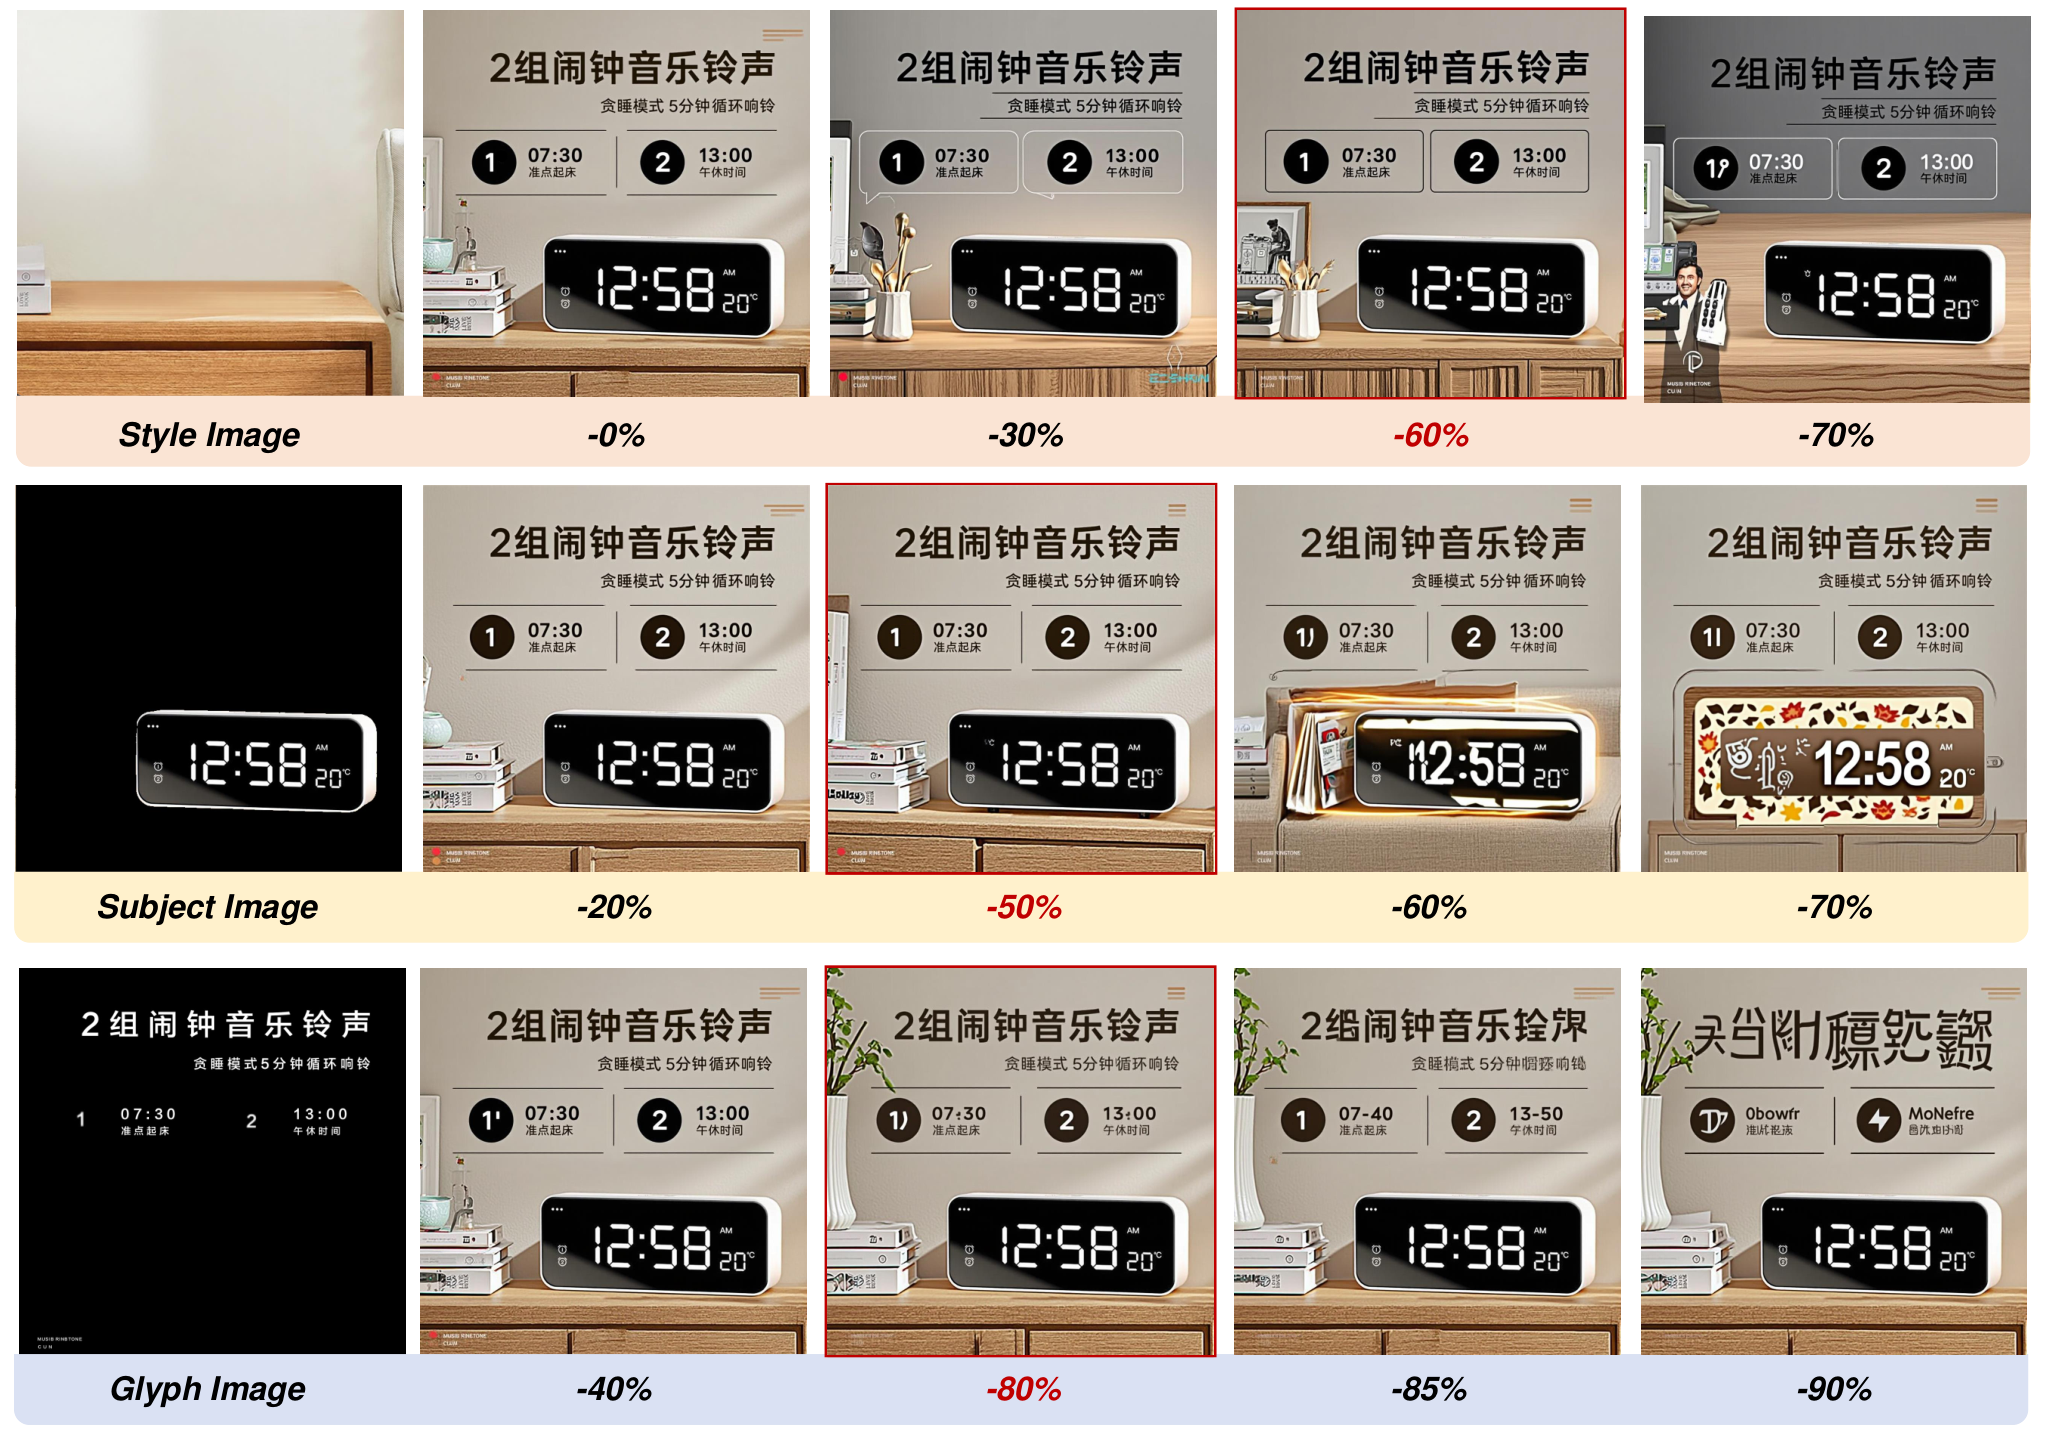
图 8:不同删除比例下的生成结果可视化。三组结果分别改变风格、商品和字形条件的 token 删除比例,参考图与生成图中的文字标签标明对应设置。随着删除比例增大,背景风格、商品外观或文字结构逐渐出现退化。
图8更直观地展示了删除比例与控制质量的关系:在一定范围内,减少冗余条件参与仍能保持良好结果;超过关键阈值后,对应条件的控制开始明显减弱。
4.5 更多生成结果
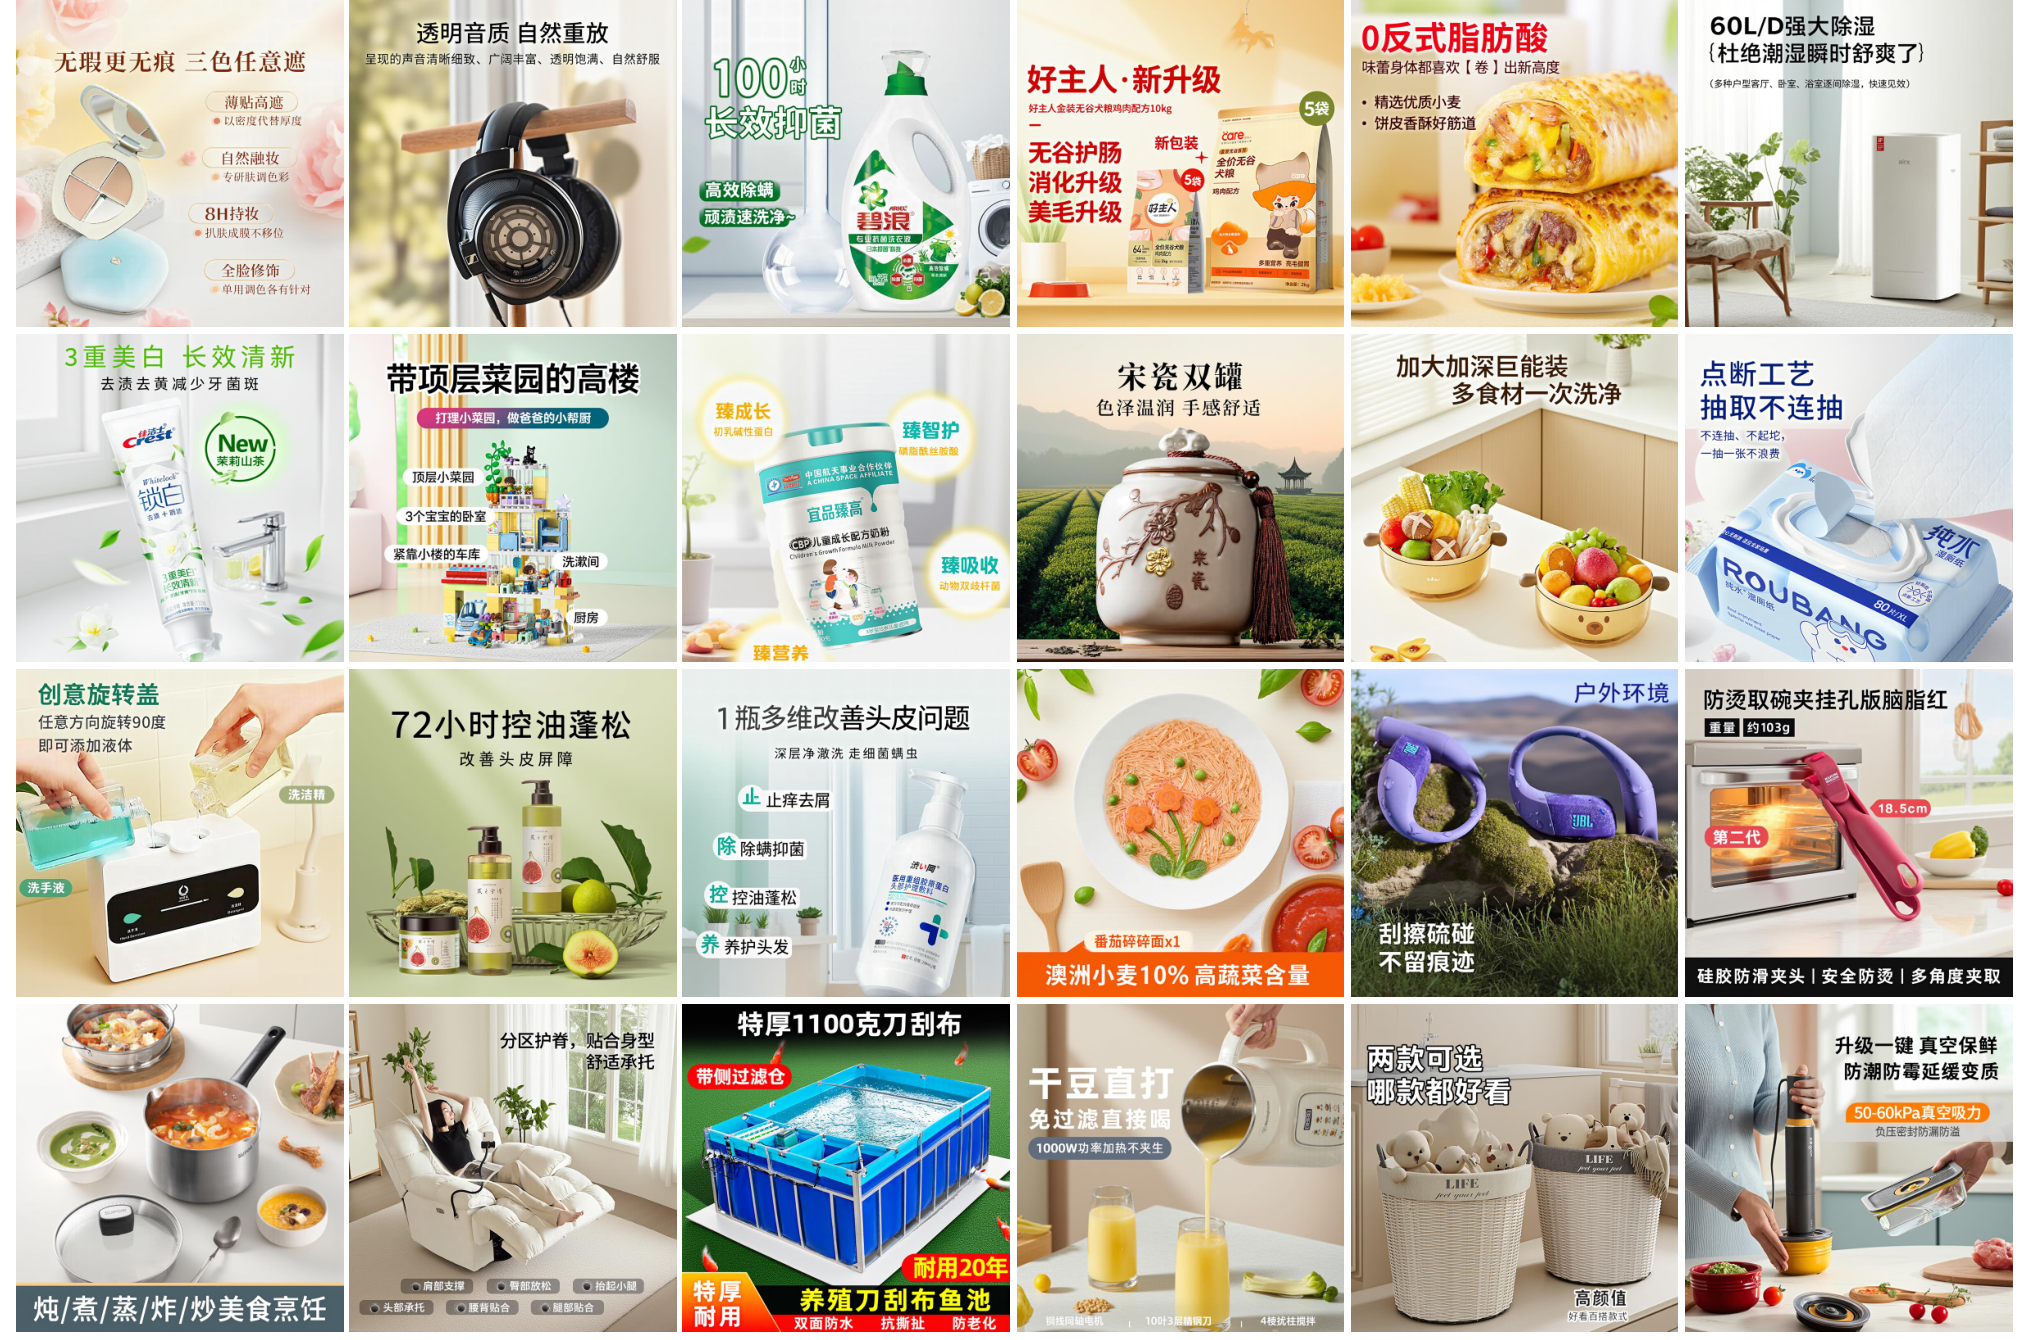
图 8:更多生成案例,展示不同商品、文字与背景风格下的联合控制效果